Gemini の構造化出力が MAX_TOKENS と 400 で失敗し続けた:thinking でも音声形式でもなく、response_schema が原因だった
Gemini API で、採点が MAX_TOKENS で失敗し続け、音声の文字起こしが 400 INVALID_ARGUMENT で失敗し続けました。どちらも最初の見立ては外れ、本当の原因は response_schema(JSON の出力の形の指定)でした。2026年9月13日と14日に測ったことと、切り分けの手順を書きます。
Gemini API で JSON を返させる時、MAX_TOKENS で止まり続けたり、400 INVALID_ARGUMENT だけが返ったりしたら、response_schema(JSON の出力の形の指定)を疑ってください。私たちは、MAX_TOKENS は「thinking が出力の枠を使っている」と、400 は「音声の形式が読めない」と考えて、どちらも外しました。本当の原因は、前者は上限の無い文字列や配列でのループ、後者は maxItems の値でした。
接客の録音アプリ(TalkLens)では、録音の文字起こしと採点に Gemini を使っています。2026年9月13日と14日に、2つの失敗が続けて起きました。どちらも、最初の見立てが間違っていて、間違いに気づくのに時間がかかりました。この記事は、その記録です。モデルの名前や上限の数字は、その時点で測った値で、いまも同じとは限りません。お客様の文や、プロンプトの全文は書きません。
失敗1:採点が MAX_TOKENS で、2回続けて失敗した
本番で、採点が2回続けて MAX_TOKENS(出力の枠を使い切って止まること)で失敗しました。1回あたり約90秒かかったうえでの失敗でした。
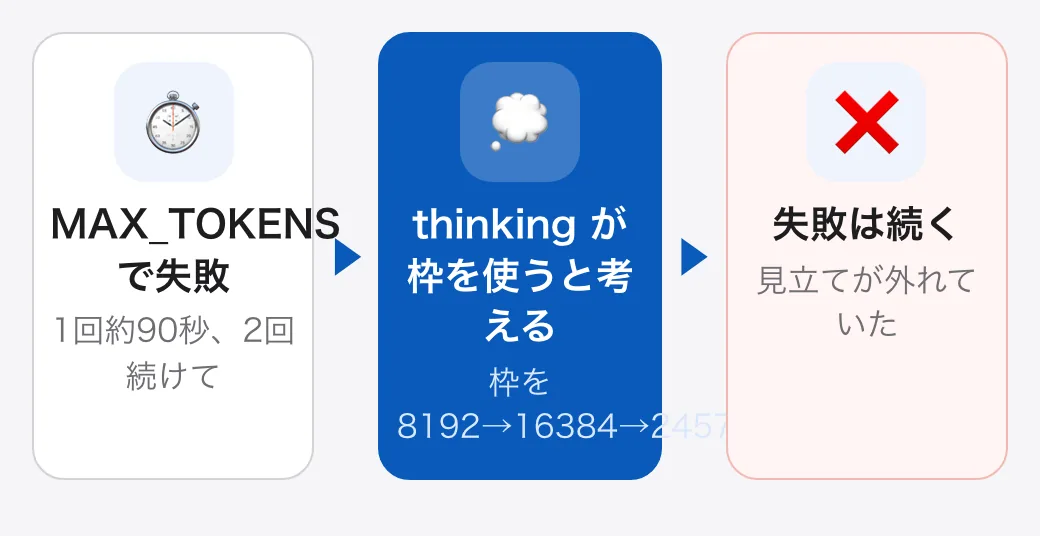
測ってみると、thinking は原因ではなかった
同じ文字起こし(2,461文字、有効な項目30個)で、thinking の量を測りました。
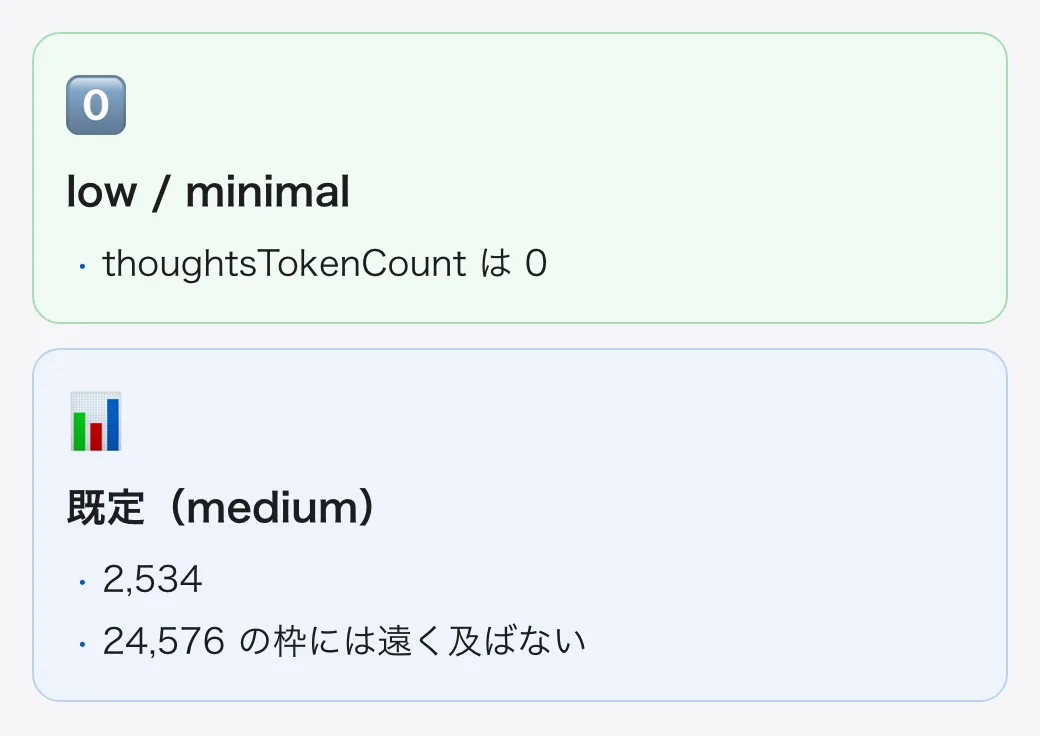
| thinking の設定 | thinking に使われた量(thoughtsTokenCount) |
|---|---|
| low | 0 |
| minimal | 0 |
| 指定しない(既定は medium) | 2,534 |
既定の設定でも2,534で、24,576の枠を使い切る量には、まったく足りません。thinking は原因ではありませんでした。
本当の原因は、出力のループだった
本当の原因は、構造化出力(response_schema)のデコーダが、同じ言葉の繰り返しに入り込み、出力の上限まで走り続けることでした。
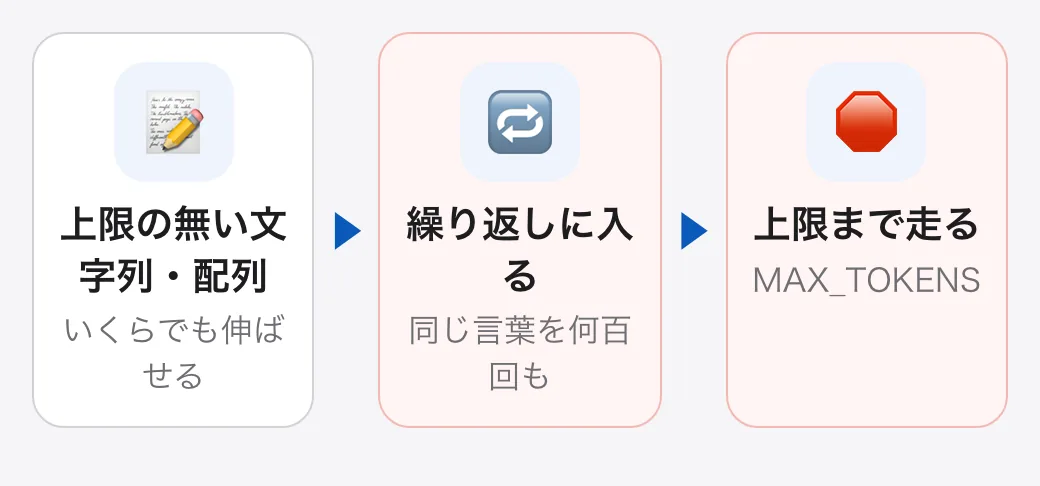
直し方:長さの上限を付け、出力の枠は逆に下げた
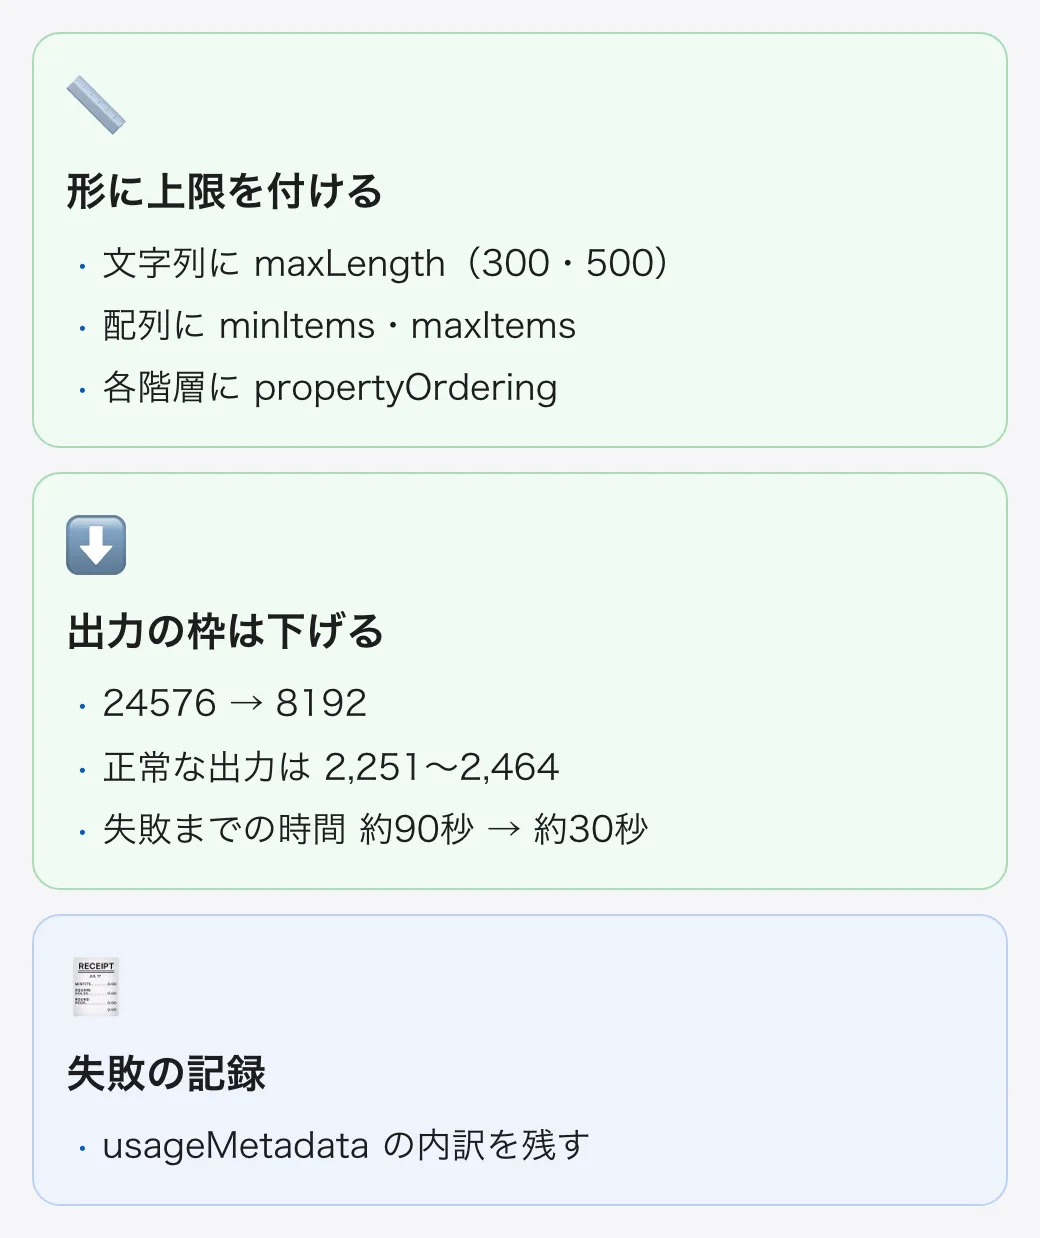
直したあと、実データで3回続けて成功し、30項目すべてが毎回返りました。
失敗2:音声の文字起こしが、400 INVALID_ARGUMENT で失敗した
別の失敗は、音声の文字起こしでした。Gemini が 400 INVALID_ARGUMENT を返し続けました。
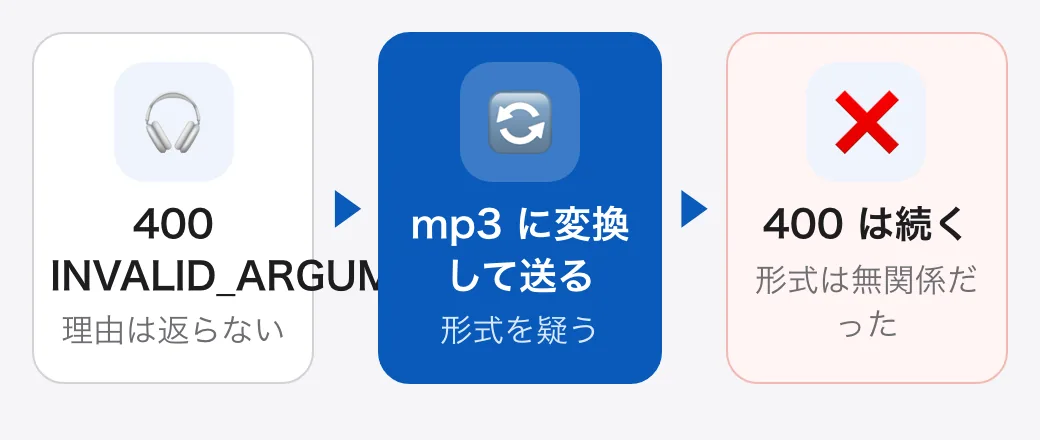
切り分け:同じ音声を1回だけ上げ、リクエストの組み立てだけを変えた
形式を疑うのをやめ、送る側の組み立てを1つずつ変えて確かめました。
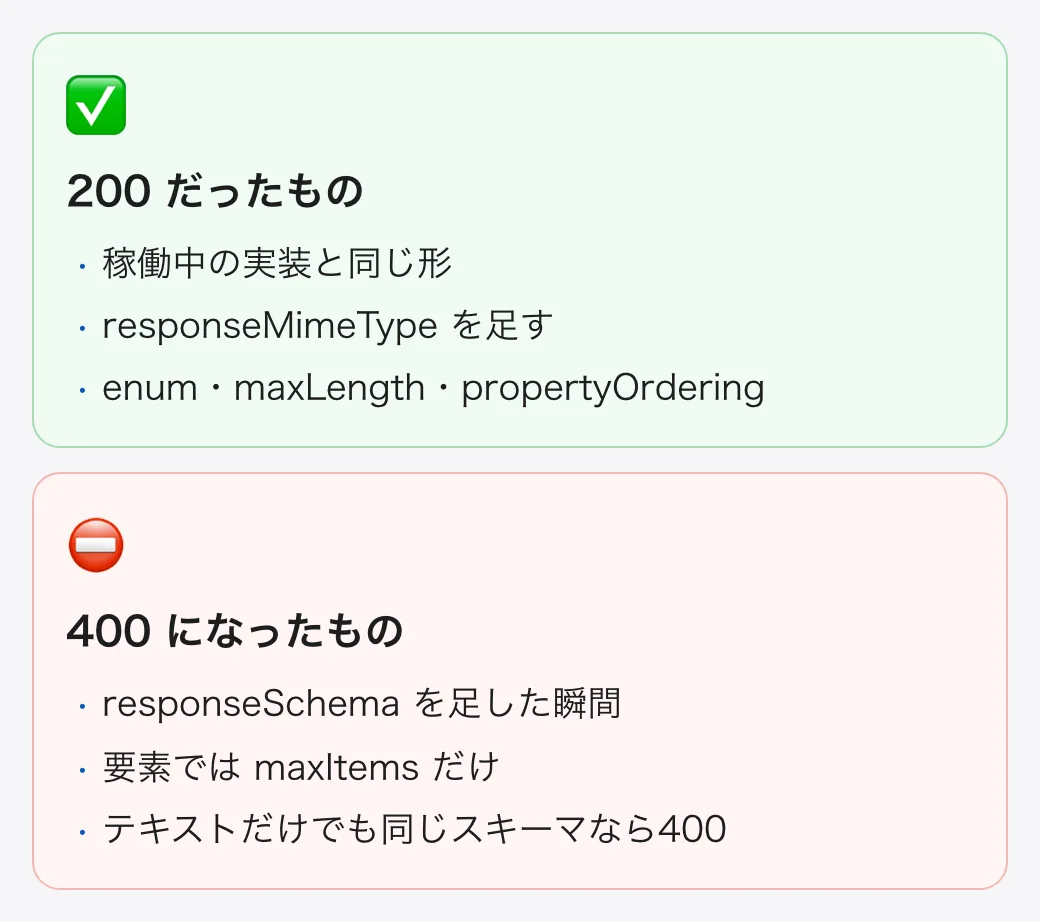
同じ音声を、1回だけアップロードする
音声は固定します。変えるのは、リクエストの組み立てだけです。
すでに動いている実装と同じ形で送る
すでに稼働していた実装(259件の実績)と同じ形で送ると、200が返りました。
1つずつ足していく
responseMimeType を足しても200。responseSchema を足した瞬間に、400になりました。
スキーマの中身を、1つずつ足す
enum、maxLength、propertyOrdering は、すべて200。maxItems だけが 400 でした。
音声は、最初から無関係でした。音声を使わない、テキストだけの呼び出しでも、同じスキーマなら400になりました。
maxItems の上限は、決まった数ではなかった
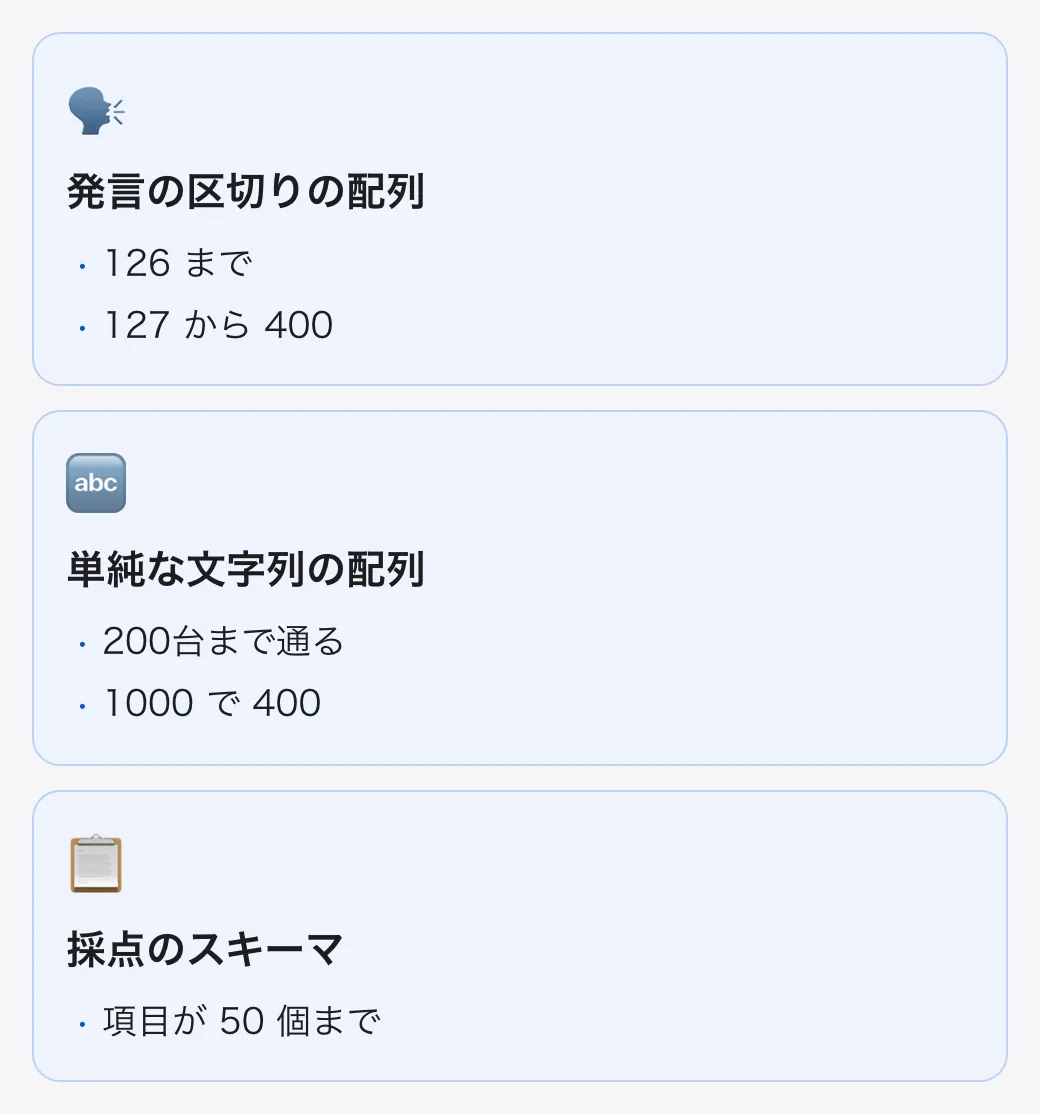
さらに調べると、maxItems には上限の値があり、その値は決まった数ではなく、スキーマ全体の大きさで変わりました。二分探索で測ると、次のとおりでした。
| スキーマ | 通った最大の maxItems |
|---|---|
| 文字起こしの発言の区切りの配列 | 126(127から400) |
| 単純な文字列の配列 | 200台まで通り、1000で400 |
| 採点のスキーマ | 項目が50個まで |
直し方と、前の結論の訂正
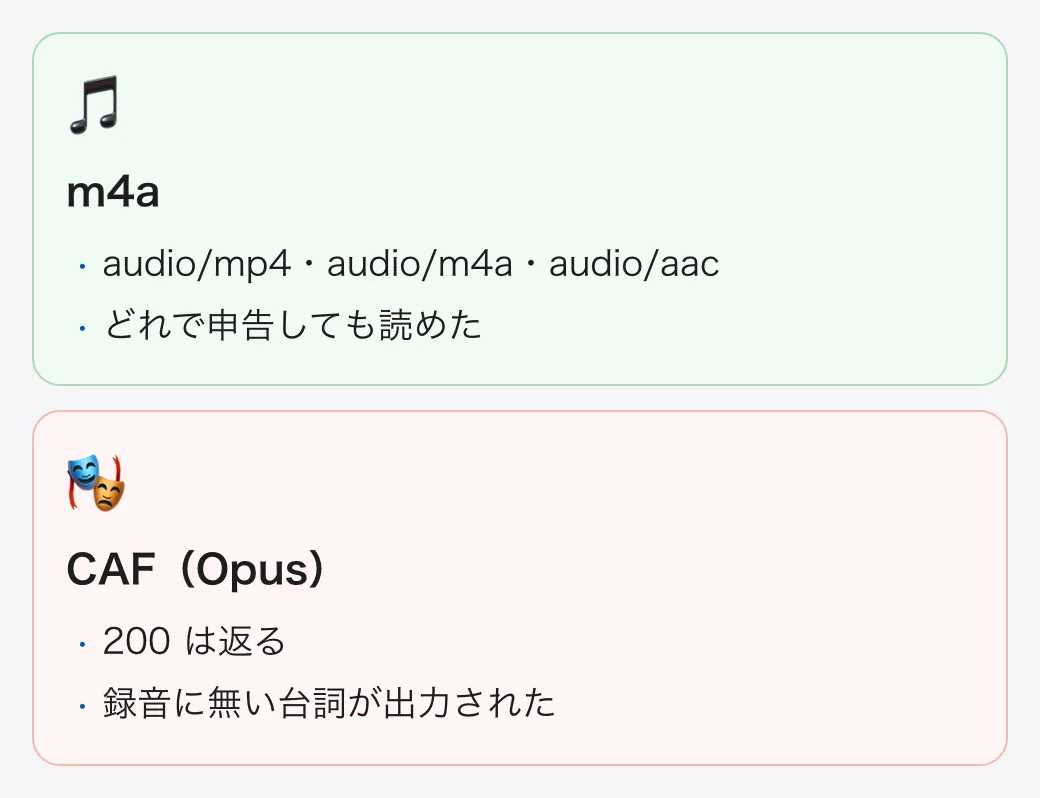
maxItems を外して形式をもう一度確かめると、「Gemini は m4a と CAF を読めない」という前の結論も、間違いでした。m4a は、audio/mp4、audio/m4a、audio/aac のどれで申告しても、正しく読めました。
まとめ
- MAX_TOKENS が続く時、thinking を疑う前に、thoughtsTokenCount を測る。今回は原因ではなかった
- 原因は、response_schema の上限の無い文字列や配列でのループ。maxLength などの上限を付け、出力の枠は下げる
- 400 INVALID_ARGUMENT は、同じ入力のまま、リクエストの組み立てを1つずつ変えて切り分ける
- maxItems の上限は決まった数ではなく、スキーマ全体の大きさで変わる。Gemini は理由を返さない
- 最初の見立ては、2回とも間違っていた。間違いは記録の中で訂正して、次の判断に活かす
この記事は、AI(Claude)の支援を受けて作成し、筆者が内容を確認しています。